

Empieza con material existente
Añade imágenes, video y audio en lugar de reconstruir con palabras el sujeto, la referencia de movimiento o la interpretación.
Combina un prompt con referencias de imagen, video o audio para generar videos de 4 a 15 segundos, con resolución nativa de hasta 2K y sonido estéreo sincronizado.
Empieza con un prompt o añade una imagen, fotogramas inicial y final, video o referencias de audio.
| Modos de generación | Texto a video, Imagen a video, Fotograma inicial y final, Referencia multimodal |
|---|---|
| Resolución | Hasta 2K nativo |
| Duración | De 4 a 15 segundos |
| Velocidad de fotogramas | 24 fps |
| Audio | Estéreo nativo sincronizado |
| Capacidad de referencias | Hasta 9 imágenes, 3 videos y 3 archivos de audio por generación |
| Ventajas técnicas | Seguimiento de instrucciones, detalle en textos y marcas, transferencia de movimiento entre videos y acabado visual de calidad comercial |
| Capacidad | Modelo actual MiniMax H3 | Google Veo 3.1 | Seedance 2.0 |
|---|---|---|---|
| Desarrollador | MiniMax | Google DeepMind | ByteDance |
| Resolución nativa de generación | 2K por defecto | 720p, 1080p o 4K | 480p, 720p, 1080p o 4K |
| Duración por clip | De 4 a 15 segundos | 4, 6 u 8 segundos | Hasta 15 segundos |
| Tipos de entrada | Texto, imagen, video y audio | Texto e imagen | Texto, imagen, video y audio |
| Capacidad de referencias | Hasta 9 imágenes, 3 videos y 3 clips de audio (12 archivos en total) | Hasta 3 imágenes de referencia | Hasta 9 imágenes, 3 videos y 3 clips de audio |
| Salida de audio | Estéreo nativo sincronizado | Audio nativo | Audio de dos canales |
| Edición y extensión | Edición selectiva de video | Extensión de escenas y generación con fotogramas inicial y final | Edición selectiva y extensión de video |
| Control de cámara y movimiento | Movimientos de cámara por prompt y transferencia de movimiento | Movimientos de cámara por prompt | Movimientos de cámara por prompt y transferencia de movimiento |
| Consistencia de personajes | Referencias de varias imágenes y multimodales | Hasta 3 imágenes de referencia del sujeto | Referencias de varias imágenes y video |
| Flujo de varias tomas | Generación de varias tomas en un clip de 4 a 15 segundos | Secuencias montadas a partir de clips independientes | Secuencias nativas de varias tomas de hasta 15 segundos |
Continúa a partir de material existente o cambia solo una parte de la toma sin empezar de cero.
Añade imágenes, video y audio en lugar de reconstruir con palabras el sujeto, la referencia de movimiento o la interpretación.
Vuelve a generar un personaje, objeto, entorno, acción, voz o tramo de la línea de tiempo sin perder el contexto que lo rodea.
Aprovecha un mejor seguimiento de instrucciones, textos y detalles de marca legibles, sonido sincronizado e imágenes estables para producir contenido de forma constante.
Usa el movimiento de cámara del video de referencia, la persona de la imagen y la voz del audio; después indica a MiniMax H3 cómo debe influir cada elemento en el video final.
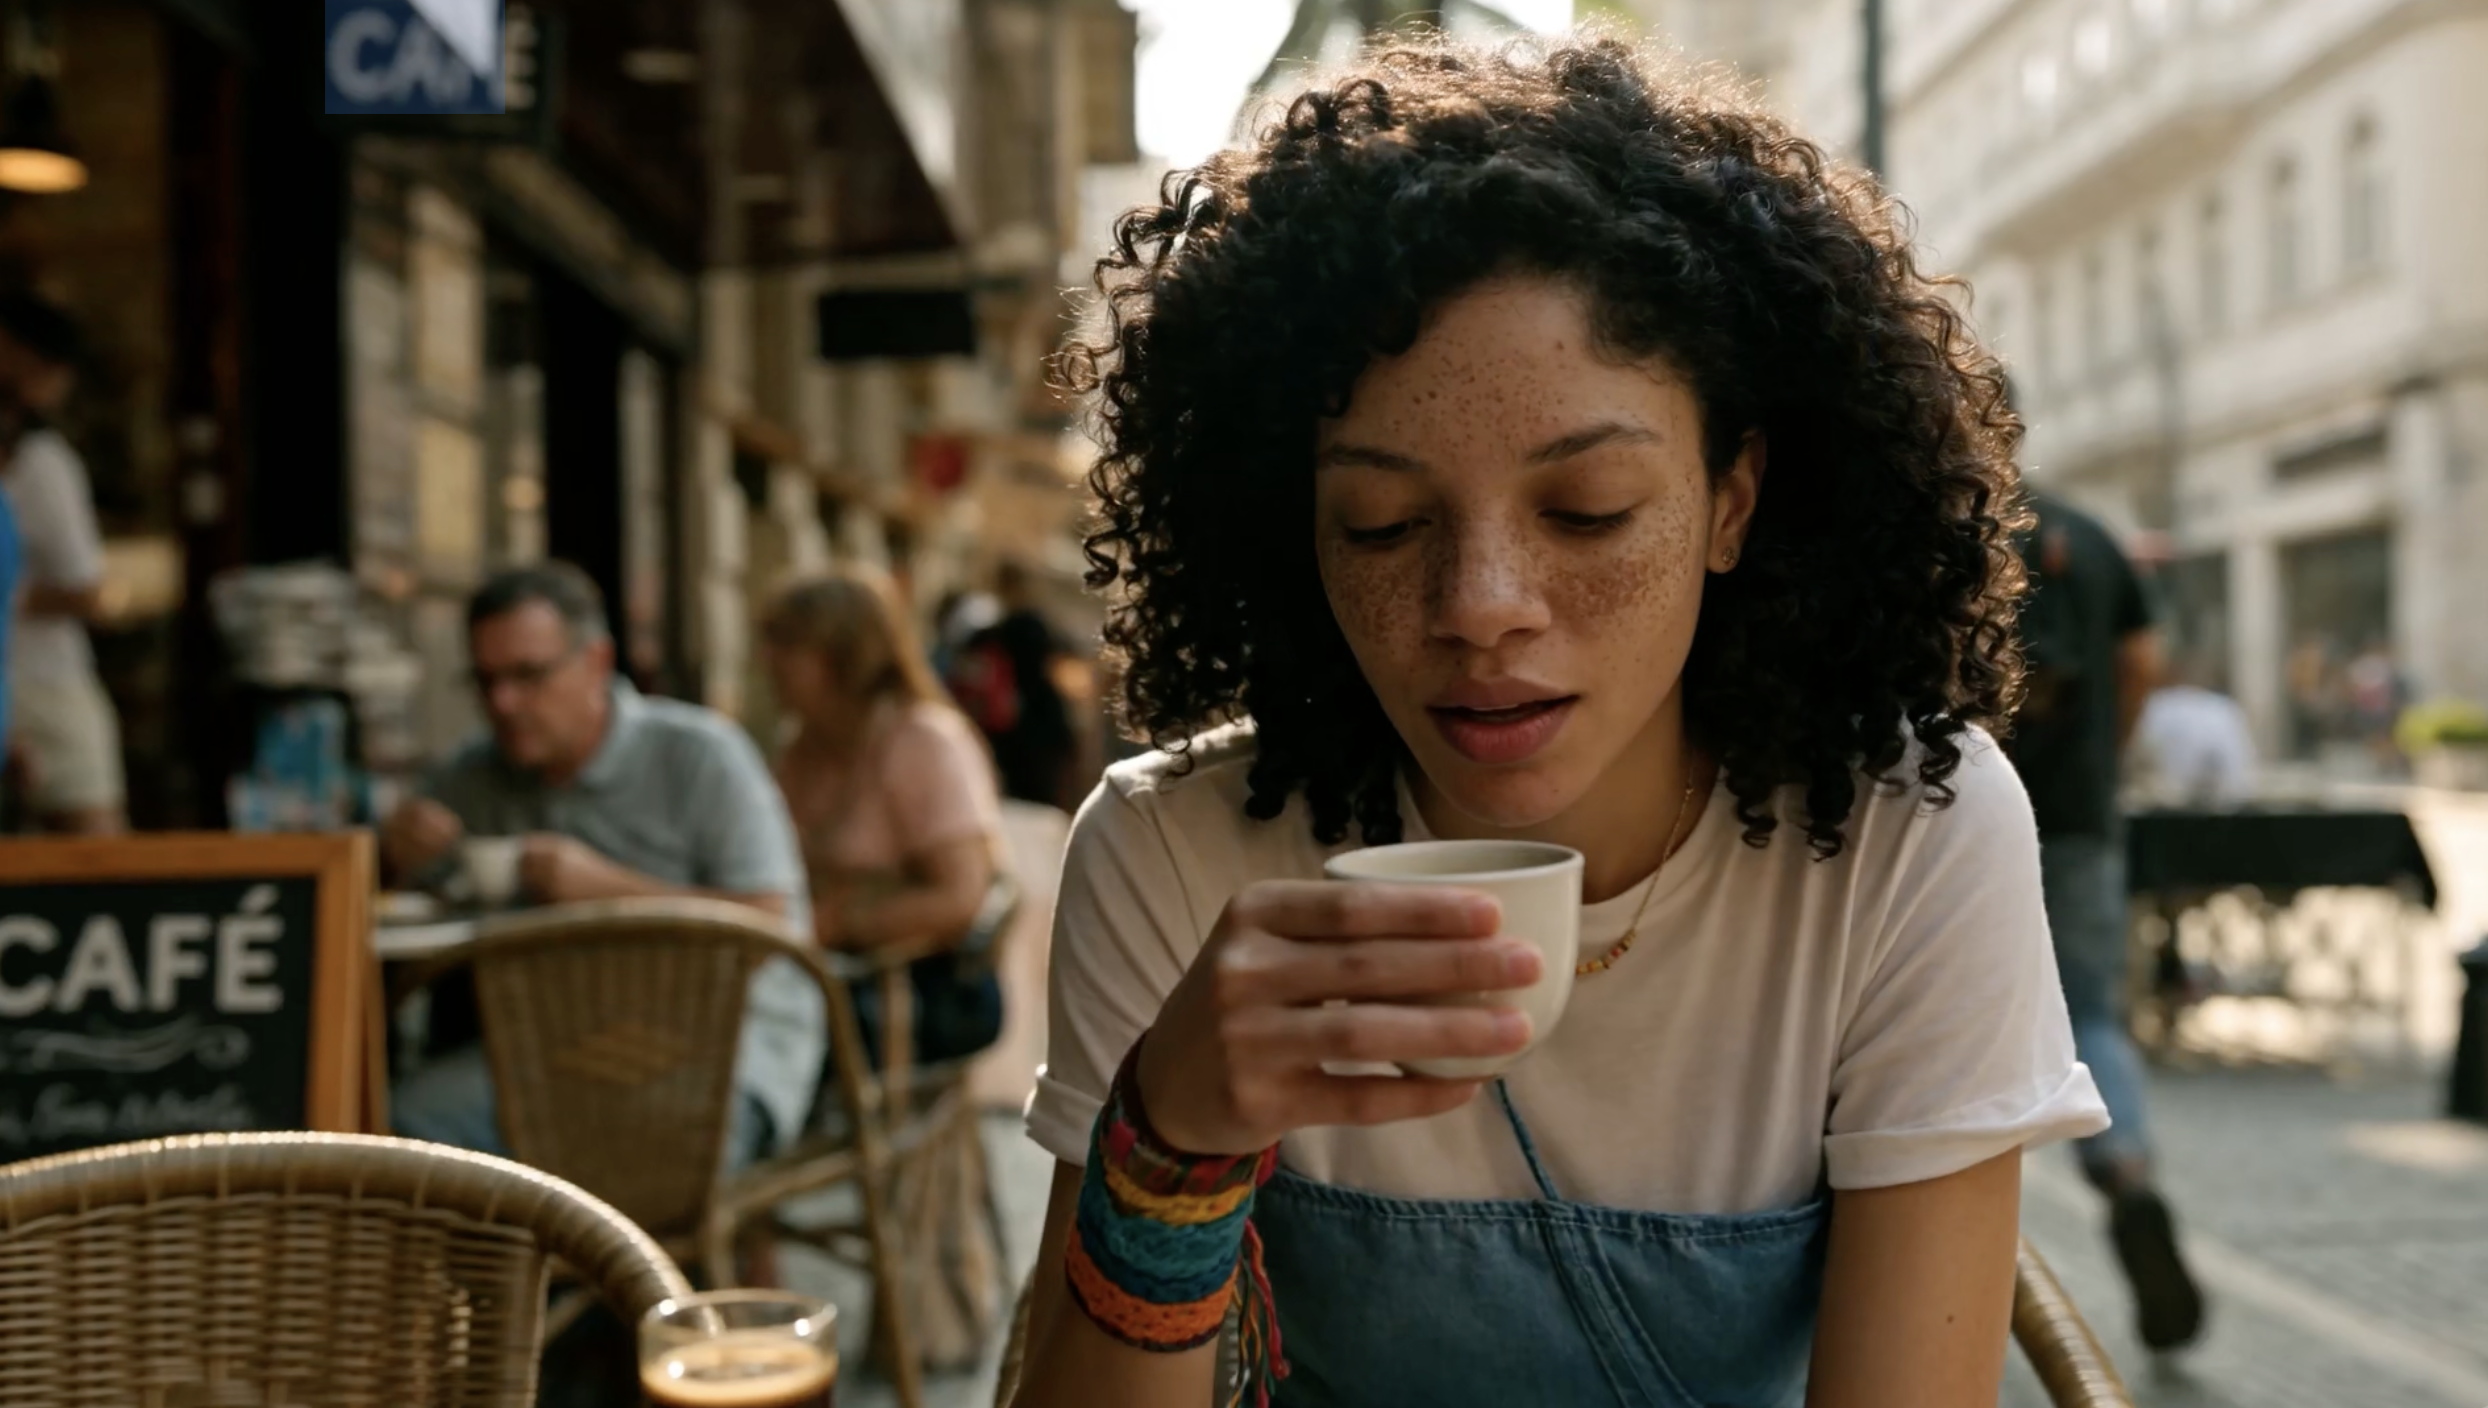
Aplica el movimiento de cámara de Hitchcock del video de referencia al personaje de la imagen de referencia y haz que cante con la voz del audio de referencia.
Reseñas prácticas populares, comparaciones directas y pruebas de creadores con MiniMax H3.
Reacciones al lanzamiento, clasificaciones independientes y pruebas comerciales compartidas en X.
Elige el plan de VidLux que mejor se adapte a tu forma de crear: videos con IA, imágenes o ambos.
Facturación anual de $276
Facturación anual de $408
Facturación anual de $924
Preguntas habituales sobre los modos de generación, los ajustes de salida, los archivos de referencia y los créditos.
Genera video de alta calidad con audio nativo sincronizado en VidLux.